


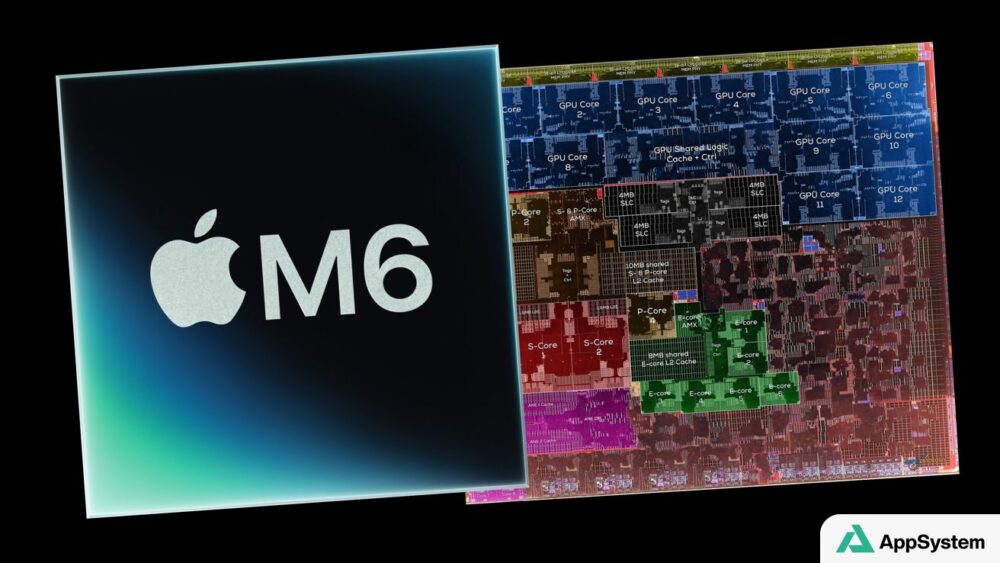
Le M6, inauguré dans le Mac mini en août, constitue la première puce Apple de classe ordinateur de bureau gravée en 2 nm. Les clichés de silicium analysés par High Yield et SemiAnalysis montrent comment Apple exploite cette finesse de gravure : la puce est physiquement plus petite que le M5, mais embarque davantage de ressources de calcul et des caches plus généreux.
Une puce plus petite, aux blocs profondément remaniés
Le M5 mesure 12,75 × 12,08 mm, soit 154 mm², et repose sur le procédé N3P de TSMC. Le M6 descend à 12,8 × 11,06 mm, pour une surface de 141,6 mm², grâce au procédé N2. Malgré cette réduction, l’organisation interne évolue nettement. L’interface mémoire reste placée dans la partie supérieure de la puce. Les configurations M6 avec 16 Go de mémoire conservent de la DRAM à 9 600 MT/s et la même bande passante que le M5 ; les versions 24 et 32 Go utilisent de la mémoire à 10 667 MT/s, portant la bande passante à 170 Go/s.
Sous cette interface, le GPU adopte une structure différente et compte deux cœurs supplémentaires. Selon l’analyse, chaque cœur graphique du M6 occupe environ 10 % de surface en moins que sur le M5. Le cache système reste fixé à 16 Mo sur les deux générations.
CPU hybride et caches nettement renforcés
Apple passe de quatre cœurs « super » et six cœurs d’efficacité sur le M5 à deux cœurs super, quatre cœurs de performance et six cœurs d’efficacité sur le M6. Les deux cœurs super conservent une taille importante, tout en étant plus compacts que ceux du M5. Ils disposent chacun de 1,5 Mo de cache L2 dédié, soit 50 % de plus, et sont reliés à deux caches L2 partagés de 10 Mo chacun.
Particularité relevée par High Yield et SemiAnalysis : les quatre cœurs de performance sont associés à ces mêmes caches partagés, formant un ensemble commun avec les cœurs super. Le groupe de six cœurs d’efficacité demeure séparé et profite de 8 Mo de cache partagé, contre 6 Mo sur le M5, ainsi que d’une unité AMX destinée aux calculs matriciels.
Le Neural Engine double également son nombre de cœurs. Son implantation est plus symétrique que sur l’A20 Pro : deux groupes de huit sections à double cœur, chacun avec son cache, rejoignent une zone de contrôle centrale.
Ce que ça change
La gravure en 2 nm ne sert donc pas seulement à réduire l’empreinte de la puce : elle permet à Apple de combiner davantage de cœurs GPU, plus de cache et une architecture CPU rééquilibrée dans une surface inférieure. Pour les usages soutenus, l’évolution des caches et l’intégration commune des cœurs super et performance constituent des éléments particulièrement importants à surveiller, car ils participent directement à l’alimentation des cœurs en données.
La partie entrées-sorties reste proche de celle du M5, mais l’analyse observe six voies à haut débit susceptibles de correspondre à du PCIe Gen 4 et de partager leur conception avec les PHY Thunderbolt. Cette interprétation, si elle se confirme, marquerait une progression par rapport aux trois voies PCIe Gen 4 et deux voies PCIe Gen 3 relevées sur le M5.
À lire aussi
Source : High Yield et SemiAnalysis (YouTube)
Rédigé avec l'assistance d'outils d'IA, vérifié et validé par la rédaction.